2–7 секунд на страницу
Печатный текст со скана, фото или PDF — на нашей RTX 3090, 2–7 секунд на страницу.
Обновлено:
Распознавание текста — превращает фото, скан или PDF в редактируемый текст: печатный — в Markdown с заголовками, таблицами и формулами. Цена — 2 ₽ за страницу. Загрузите JPG, PNG, WebP или PDF до 25 МБ; страница распознаётся за секунды. Без регистрации — до 10 ₽ в сутки. Распознавание рукописи временно недоступно.
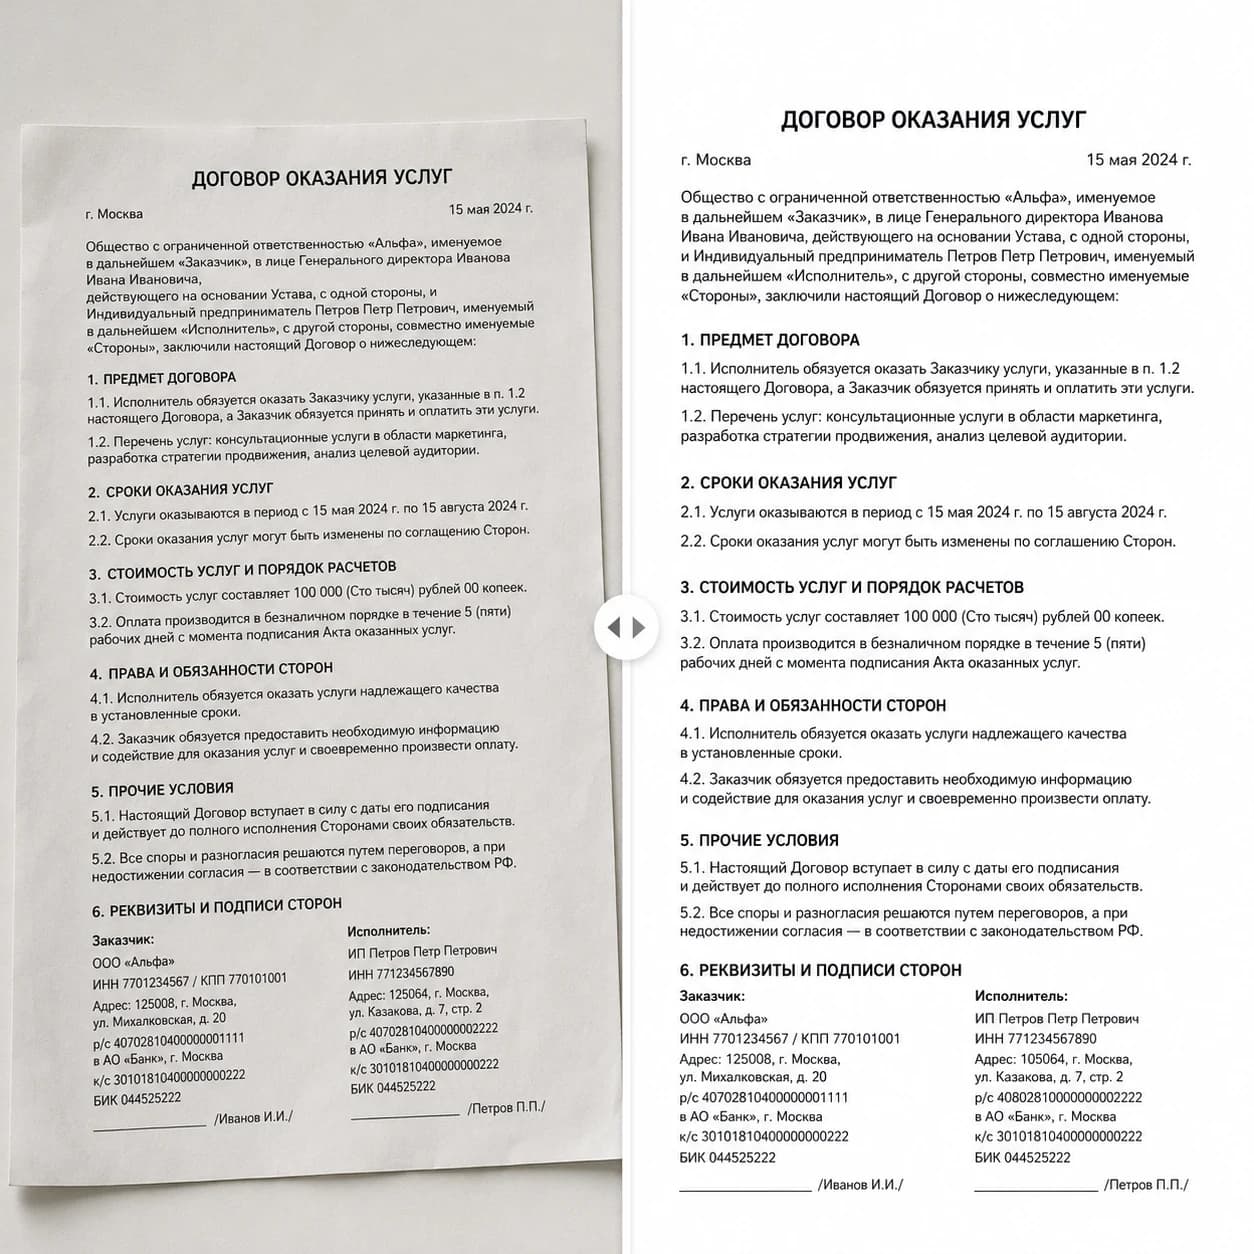
Выберите тип текста, загрузите фото — получите готовый результат за секунды. До 10 ₽ в сутки бесплатно. Регистрация — +25 ₽ после подтверждения email.
Перетащите фото сюда
или нажмите для выбора · JPG, PNG, WebP · до 25 МБ
JPG / PNG / WebP, PDF, DOC/DOCX/RTF/ODT/HTML/TXT до 25 МБ. Многостраничный PDF — оплата за каждую страницу.
Загрузите файл — результат появится здесь
Стоимость: 2 ₽ · в пределах бесплатного лимита 10 ₽ в сутки
Печатный текст — на нашем GPU быстро и дёшево. Режим «рукопись» временно недоступен.
Печатный текст со скана, фото или PDF — на нашей RTX 3090, 2–7 секунд на страницу.
На выходе не сплошной текст, а Markdown с заголовками, абзацами, списками, таблицами в формате `| col |` и формулами LaTeX. Готово к импорту в Notion, Obsidian, Word.
Загружаете многостраничный PDF — мы разбираем его постранично и возвращаем один связный Markdown. Оплата за каждую распознанную страницу.
Режим распознавания рукописи временно отключён. Печатный текст, сканы, PDF и документы распознаются как обычно.
Поддерживаем 90+ языков с автоопределением. Не нужно выбирать — загружайте русский, английский, любой смешанный текст.
REST API с webhook callback для интеграции в свой пайплайн. Пакетный режим до 50 файлов в один запрос — полезно для оцифровки архивов.
Плата по факту распознавания. До 10 ₽ в сутки бесплатно без регистрации, 25 ₽ на баланс после подтверждения email — это 12 печатных страниц.
Где обрабатывается: Печатный текст и документы — на собственных GPU PhotoPanda в России. Фото не передаётся сторонним сервисам.
Современные системы распознавания давно ушли от старого подхода с шаблонным сравнением символов. Сегодня OCR — это многоступенчатая задача глубокого обучения: нейросеть находит области с текстом, распознаёт буквы и слова, реконструирует структуру страницы и переводит формулы в LaTeX. Старые системы выдавали сплошную строку — современные возвращают готовый размеченный документ.
Для печатного текста работает движок на нашей RTX 3090 в РФ. Он делает три вещи сразу: детектит буквы (90+ языков с автоопределением), размечает страницу на блоки (заголовок, абзац, список, таблица, формула), переводит математику в LaTeX. Страница обрабатывается за 2–7 секунд. Принимает картинки и многостраничный PDF целиком — на выходе готовый Markdown с заголовками, таблицами вида | col1 | col2 |, формулами в $\\LaTeX$ и ссылками на встроенные изображения.
Для рукописи обычные OCR-движки работают плохо: каждый человек пишет своим почерком, буквы соединяются курсивом, наклон отличается. Для неё нужна multimodal-модель Vision-класса. Режим «рукопись» сейчас временно недоступен — печатный текст, сканы и PDF распознаются как обычно.
100% точности не бывает. Печатный режим может ошибиться на очень мелком тексте (ниже 8pt в фотопикселях), сильном расфокусе, нестандартных декоративных шрифтах. В таких случаях помогает предварительный апскейл нейросетью: увеличиваем разрешение и резкость, потом распознаём уже на чётком исходнике.
Сфотографировал страницу учебника или конспект — получил текст, можно искать ключевые слова, копировать в реферат, переводить через DeepL. Бонуса 25 ₽ после подтверждения email хватит на 12 печатных страниц.
Сканы документов — счета, акты, договоры, протоколы. После распознавания текст легко скопировать в учётную программу, отправить контрагенту, заархивировать с поиском по содержимому. Через API можно автоматизировать обработку: настройте отправку отсканированных документов на наш endpoint, получайте JSON с текстом и метаданными в свою CRM/ERP.
Газеты, книги, машинописные справки и печатные документы из семейных архивов распознаются в печатном режиме — 2 ₽ за страницу. Пакетный режим до 50 файлов позволяет оцифровать целую подшивку за один заход. Рукописные письма и дневники сейчас не распознаём: режим «рукопись» временно недоступен.
Фотография инфографики на конференции, цитата из старой газеты, скан архивного документа. Распознать, скопировать, использовать в статье. Сохранение структуры по строкам и абзацам — важно при цитировании.
Конкурентная разведка: фотография ценника в офлайн-магазине, фото описания товара у конкурента — получаете текст для своего предложения. Распознавание этикеток для каталога — отправляйте партии через API, получайте структурированные данные.
REST API с OpenAPI 3.1 документацией, асинхронный режим с webhook callback. Интегрируйте в свой пайплайн обработки документов, индексирования сканов, поиска по фото. JSON-ответ содержит координаты строк (bbox) — можно реконструировать структуру таблиц и форм.
После распознавания под результатом есть кнопки скачивания: DOCX для Word, а также PDF, Markdown и TXT. В файл переносится распознанный текст с его структурой — заголовки, абзацы, списки, для печатного текста ещё таблицы и формулы.
Исходная вёрстка страницы не сохраняется: колонки, шрифты, картинки и точное расположение блоков в Word не переносятся. Это перевод фото в текст, а не конвертер PDF в Word один в один — документ с вёрсткой потребует ручного оформления после распознавания.
OCR (Optical Character Recognition) — оптическое распознавание печатного текста: сканов документов, скриншотов, фото книжных страниц. У нас современный движок на GPU, который не просто выдёргивает символы, а реконструирует структуру: заголовки, абзацы, списки, таблицы, формулы. На выходе — готовый Markdown. Распознавание рукописи — отдельная задача для multimodal-модели Vision-класса; этот режим сейчас временно недоступен. Цена печатного текста — 2 ₽ за страницу.
В PhotoPanda — 2 ₽ за страницу печатного текста. Это в десятки раз дешевле зарубежных сервисов вроде ABBYY FineReader Online (от 100 ₽/страница) и Adobe Scan (подписка от 600 ₽/мес). Платите только за успешные распознавания — если нейросеть не смогла прочитать, баланс возвращается автоматически. Режим «рукопись» временно недоступен.
Да. Без регистрации — до 10 ₽ в сутки на IP-адрес: это 5 печатных страниц; лимит обновляется в 03:00 по Москве. После регистрации — 25 ₽ на баланс после подтверждения email: 12 печатных страниц. Карта при регистрации не нужна.
Поддерживаем 90+ языков с автоопределением. Не нужно выбирать язык вручную: загружайте русский, английский, китайский, арабский, смешанные документы.
Файлы JPG, PNG, WebP или PDF до 25 МБ. По разрешению — без ограничений. Оптимально 300 DPI на сканах документов (стандарт качества), но мы хорошо справляемся и с фото на телефоне в нормальном свете.
На чистых сканах документов и обычных шрифтах (Times, Arial, Calibri) — ~98% точности и корректная структура (заголовки/таблицы/формулы). На фото с телефона с нормальным освещением — 95–97%. Сложные случаи (мятая бумага, неравномерное освещение, очень мелкий текст) — 85–95%. Сравнимо с ABBYY FineReader, и в плане структуры (таблицы/Markdown) часто лучше.
Сейчас нет: режим распознавания рукописи временно недоступен. Печатный режим рассчитан на типографский текст и почерк не разбирает. Печатные страницы, сканы и PDF распознаются как обычно.
Печатные — да. Печатный режим справляется с типографским шрифтом советских книг и газет, включая таблицы и формулы. Дореформенная орфография (ять, фита, ижица) — частично, лучше тестируйте на конкретном документе. Рукописные документы сейчас не распознаём: режим «рукопись» временно недоступен.
Да. Загружаете PDF целиком — мы сами разбираем его постранично и возвращаем один связный Markdown-документ со всей структурой. Не нужно конвертировать в картинки, не нужно склеивать страницы. Оплата за каждую распознанную страницу (2 ₽). Максимум 50 страниц за один файл.
Markdown (.md): заголовки, абзацы, таблицы вида `| col1 | col2 |`, формулы LaTeX, ссылки на figures. Готово к импорту в Notion, Obsidian, Word, любой редактор. Через API дополнительно возвращается JSON с метаданными (page_count, source, duration_ms).
Да. В личном кабинете на вкладке «Пакетно» загружаете до 50 файлов за раз — на выходе ZIP-архив со всеми результатами. Через API (POST /api/v1/v1/photos/batch) то же ограничение — до 50 файлов на запрос, число запросов не ограничено. Цена та же: от 2 ₽ за страницу, без наценок на пакет.
Да: документы распознаются на собственных GPU-серверах в РФ, связь с ними идёт по зашифрованному каналу, документы не передаются третьим лицам, не индексируются и не используются для обучения моделей. Загруженные исходники удаляются в течение 24 часов после распознавания. Результат хранится в истории личного кабинета 30 дней и затем удаляется автоматически, результат без регистрации — 1 час. Соединение с сайтом и API — по HTTPS.
Да. REST API: POST /api/v1/v1/photos/process с заголовком X-API-Key, в теле — multipart/form-data с файлом и параметром operation=ocr_markdown. Распознанный текст приходит в поле outputText JSON-ответа. Для пакетов — POST /api/v1/v1/photos/batch: с webhookUrl по готовности придёт callback с HMAC-SHA256 подписью. Используйте для автоматизации обработки документооборота, оцифровки архивов, индексации сканов. Подробности на /api-docs.
OCR — один из инструментов PhotoPanda: создавайте фото с ИИ, обрабатывайте нейросетью и распознавайте текст в одном сервисе.
Создайте фото с ИИ за минуту: готовые шаблоны локаций, переодевание нейросетью, сохранение лица. От 12 ₽.
Открыть →Увеличить разрешение скана перед OCR для лучшего распознавания. От 1 ₽ за фото.
Перейти →Восстановите старый документ с надписями и пометками, распознайте текст после реставрации. От 12 ₽.
Перейти →Опишите словами, что изменить — нейросеть применит правки. 4 модели, от 12 ₽.
Перейти →Прозрачный PNG за 1–2 секунды — для документов с логотипом, печати, сканов. От 20 копеек.
Перейти →REST + webhook для интеграции OCR в свой пайплайн обработки документов и архивов.
Перейти →AI-фотосессия по шаблону, генерация изображений нейросетью или обработка вашего фото — удаление фона, апскейл до 1440p, восстановление лиц. 10 ₽ в сутки бесплатно без регистрации, после регистрации — 25 ₽ на баланс после подтверждения email: хватит на 125 удалений фона. Без карты и подписки. Без водяного знака после первого пополнения.