Фото в текст: как распознать текст с фото онлайн
Как перевести фото в текст онлайн: как снять документ для точного распознавания, что происходит с таблицами и PDF, как сохранить результат в Word и сколько это стоит — 2 ₽ за страницу.
- Автор: Команда PhotoPanda
- Опубликовано:
- 7 мин чтения
- 104 просмотра
- фото в текст
- OCR
- распознавание текста
- Word
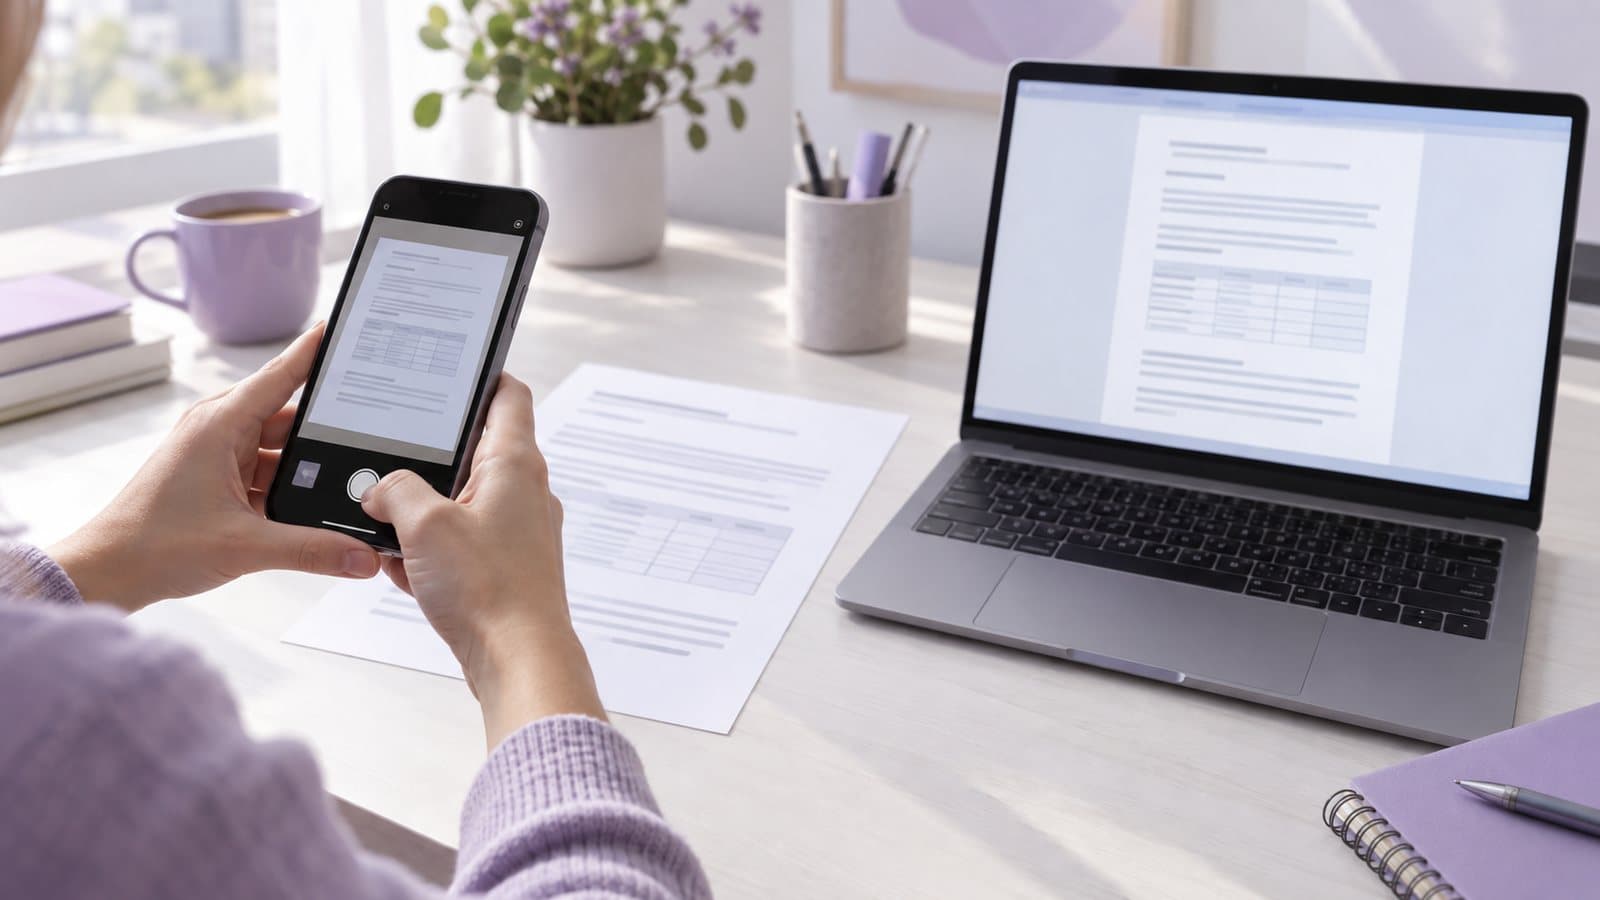
Перевести фото в текст — значит распознать буквы на снимке и получить обычный текст, который можно скопировать, поправить и сохранить в Word. Онлайн это делает OCR-нейросеть: вы загружаете фото, скан или PDF и через несколько секунд получаете текст с заголовками, списками и таблицами. В PhotoPanda страница печатного текста стоит 2 ₽.
Ниже — как снять документ, чтобы распознавание не спотыкалось, что происходит с таблицами и многостраничными PDF, как выгрузить результат в Word и чего OCR пока не умеет. И отдельно, честно, про рукописи: этот режим у нас сейчас временно недоступен.
Как работает распознавание текста с фото
OCR (optical character recognition, оптическое распознавание символов) решает четыре задачи подряд:
- Находит текст на изображении — строки и блоки, отделяя их от картинок, печатей и фона.
- Распознаёт символы в каждой строке. Современные движки читают строку целиком, а не по буквам, поэтому лучше справляются с плотным и мелким шрифтом.
- Разбирает макет: где заголовок, где абзац, где таблица, колонтитул или сноска.
- Восстанавливает порядок чтения — чтобы текст из двух колонок не перемешался построчно.
В PhotoPanda печатный текст распознаёт открытый движок Marker на моделях Surya. Он работает на собственных GPU-серверах PhotoPanda в России. Язык определяется автоматически, выбирать его вручную не нужно. На выходе — Markdown: текст со структурой, который открывается в любом редакторе и конвертируется в Word без потери заголовков и таблиц.
Что можно перевести в текст: фото, сканы, PDF и документы
| Что загружаете | Что происходит | Цена |
|---|---|---|
| Фото или скриншот (JPG, PNG, WebP) | Распознавание одной страницы | 2 ₽ |
| Скан документа | То же, что фото; на чистом скане точность выше | 2 ₽ за страницу |
| Многостраничный PDF | Разбирается постранично, на выходе один связный документ | 2 ₽ за каждую страницу |
| DOC, DOCX, RTF, ODT, HTML, TXT | Распознавание не нужно, текст уже в файле — конвертируем в Markdown | 2 ₽ за файл |
Максимальный размер файла — 25 МБ. Снимки в формате HEIC с iPhone лучше заранее сохранить в JPG — как это сделать за минуту, мы разбирали в статье HEIC в JPG: как открыть и конвертировать фото с iPhone.
Как сфотографировать документ, чтобы текст распознался
Половина ошибок OCR — это ошибки съёмки. Пять правил, которые экономят время на исправлениях:
- Ровный свет без бликов. Глянцевая бумага под лампой даёт белое пятно, и буквы под ним пропадают. Лучше рассеянный дневной свет у окна.
- Камера параллельно листу. Снимайте сверху, а не под углом: перспектива сжимает дальние строки.
- Лист целиком в кадре, с небольшими полями. Обрезанный край — потерянные слова.
- Без сжатия. Мессенджеры пережимают фото при пересылке. Отправляйте файлом или загружайте прямо с телефона.
- Резкость важнее разрешения. Смазанный снимок 12 Мп хуже чёткого 3 Мп. Для сканера стандарт — 300 dpi, этого хватает для обычного кегля.
Если фото плохого качества
Частый вопрос — можно ли сначала увеличить размытое фото нейросетью, а потом распознать. Не советуем. Апскейл дорисовывает детали по вероятности, и на тексте он может «нарисовать» уверенную, но неправильную букву: 3 вместо 8, «ш» вместо «щ». OCR потом прочитает её без сомнений. Если документ под рукой, переснимите его. Если нет — распознавайте как есть и внимательно вычитайте цифры и фамилии.
Таблицы, заголовки и формулы: что сохраняется
Главное отличие нейросетевого OCR от «копировать текст с картинки» в телефоне — структура. Сохраняются:
- заголовки разных уровней;
- абзацы и списки — маркированные и нумерованные;
- таблицы — строки и столбцы, а не каша из чисел через пробел;
- формулы — в формате LaTeX, который понимают Word, Notion и Obsidian.
Что не сохраняется: шрифты, цвета, точное положение блоков на странице, картинки внутри документа. Результат — это текст со структурой, а не копия вёрстки. Если нужен документ «как в оригинале» — с печатями и подписями на своих местах, — храните скан рядом с распознанным текстом.
Как перевести текст с фото в Word
Запрос «текст с фото в ворд» набирают около 3 700 раз в месяц. В PhotoPanda после распознавания результат скачивается в четырёх форматах:
- DOCX — для Word: заголовки становятся стилями заголовков, таблицы — таблицами Word;
- PDF — чтобы отправить или распечатать;
- MD — Markdown для Notion, Obsidian и других редакторов заметок;
- TXT — простой текст без разметки.
Чего ждать: DOCX получится аккуратным документом со структурой, но с оформлением по умолчанию. Шрифты, отступы и колонки оригинала не переносятся — это свойство любого OCR, а не только нашего.
Как распознать текст с фото онлайн в PhotoPanda: пошагово
- Откройте страницу распознавания текста. Регистрация для пробы не нужна.
- Загрузите фото, скан, PDF или текстовый документ до 25 МБ.
- Дождитесь результата: печатная страница распознаётся за несколько секунд, PDF — постранично.
- Проверьте текст, особенно цифры, даты и имена собственные.
- Скопируйте его или скачайте в DOCX, PDF, MD или TXT.
Для архива сканов в личном кабинете есть пакетный режим — до 50 файлов за раз. Разработчикам доступен API: операция ocr_markdown, распознанный текст приходит в поле outputText ответа.
Сколько стоит и можно ли бесплатно
Цена — 2 ₽ за страницу печатного текста, без подписки. Бесплатно можно так:
- Без регистрации — до 10 ₽ в сутки на IP-адрес, то есть 5 страниц. Лимит обновляется в 03:00 по Москве.
- После регистрации — 25 ₽ на баланс после подтверждения email, это 12 страниц.
- Ежедневный долив — если баланс меньше 10 ₽, раз в сутки он доливается до 10 ₽ при подтверждённом email. Неиспользованный долив не копится.
Водяных знаков на тексте нет. Если распознавание завершилось ошибкой, деньги возвращаются на баланс автоматически.
Рукописный текст: почему режим сейчас недоступен
Около 1 200 человек в месяц ищут «фото в рукописный текст», ещё 800 — «рукописный текст в печатный по фото». Почерк — отдельная задача: буквы соединены, у каждого свой наклон и свои сокращения, а печатные движки на таком обучены плохо. Для рукописей у PhotoPanda был отдельный режим на внешней модели, но сейчас он временно отключён, и включить его в ближайшие дни мы не обещаем.
Что можно сделать уже сейчас: разборчивые печатные буквы, написанные от руки, — например, анкету, заполненную по клеточкам, — печатный режим иногда читает. Со связным почерком результат непредсказуем, поэтому на него лучше не рассчитывать и не тратить деньги.
Конфиденциальность: где обрабатываются документы
Печатный текст и документы распознаются на собственных GPU-серверах PhotoPanda в России и никуда дальше не передаются. Загруженный файл удаляется в течение 24 часов после распознавания. Результат, включая сам распознанный текст, хранится в истории личного кабинета 30 дней, с купленным дополнительным хранилищем — пока оно оплачено. Результат без регистрации хранится 1 час. Если распознаёте старые семейные документы и письма, пригодится и наш гайд по восстановлению сканов документов и фотографий.
Частые вопросы
Как перевести фото в текст онлайн бесплатно?
Откройте страницу распознавания текста PhotoPanda и загрузите фото — регистрация не нужна. Без аккаунта доступно до 10 ₽ в сутки на IP-адрес, это 5 страниц печатного текста; лимит обновляется в 03:00 по Москве. После регистрации и подтверждения email на баланс приходит ещё 25 ₽ — это 12 страниц. Водяных знаков и подписок нет, платите только за распознанные страницы.
Сохраняются ли таблицы при распознавании?
Да. Движок разбирает макет страницы и возвращает таблицы как таблицы — со строками и столбцами, а не числа через пробел. В DOCX они становятся обычными таблицами Word. Не переносятся оформление ячеек, цвета и точная ширина столбцов. На сложных таблицах с объединёнными ячейками результат стоит проверить глазами, особенно если по ним потом что-то считают.
Можно ли распознать многостраничный PDF?
Да. Загрузите PDF целиком — движок разберёт его постранично и вернёт один связный документ с сохранённой структурой. Разбивать файл на картинки и склеивать результат вручную не нужно. Оплата — 2 ₽ за каждую страницу, то есть документ на 10 страниц обойдётся в 20 ₽. Максимальный размер файла — 25 МБ; стоимость видна до запуска.
Можно ли распознать рукописный текст с фото?
Сейчас нет: режим распознавания рукописей временно недоступен, и сроков включения мы не обещаем. Печатный режим рассчитан на типографский шрифт. Аккуратные печатные буквы от руки, например в анкете по клеточкам, он иногда читает, но со связным почерком результат непредсказуем. Для рукописей лучше дождаться возвращения отдельного режима.
Насколько точно распознаётся текст?
Точность зависит от исходника сильнее, чем от движка. На чистом скане с обычным шрифтом правок обычно немного. На фото под углом, с бликом или после пересжатия в мессенджере — заметно больше. Всегда вычитывайте цифры, даты, фамилии и суммы: OCR путает похожие символы, а в документах именно они важнее всего.
Безопасно ли распознавать документы с персональными данными?
Печатный текст распознаётся на собственных серверах PhotoPanda в России, документы не передаются третьим лицам. Исходный файл удаляется в течение 24 часов после распознавания, результат хранится в истории личного кабинета 30 дней, без регистрации — 1 час. После этого удаляется и сам распознанный текст. Соединение с сайтом защищено HTTPS.
Коротко
Чтобы перевести фото в текст онлайн, загрузите снимок, скан или PDF на страницу распознавания. Через несколько секунд вы получите текст с заголовками, списками и таблицами, который скачивается в Word, PDF, Markdown или TXT. Страница печатного текста стоит 2 ₽, без регистрации можно распознать до 5 страниц в сутки. Лучший способ повысить точность — снять документ ровно, при хорошем свете и без сжатия. Рукописный режим пока недоступен.
Материал подготовила
Команда PhotoPanda
Редакция сервиса обработки фото PhotoPanda.